 Lotook
استكشف المجلة
مقالات تحمل الوسم نماذج الذكاء الاصطناعي — الصفحة 2
كل مقالات Lotook التي تحمل الوسم نماذج الذكاء الاصطناعي: أخبار وتحليلات وأدلة عملية مع روابط للمصادر الأصلية. تصفح الصفحة 2 من 3.
Gemini 4 Carbon متاح الآن: السعر وإمكانية الوصول والمقارنة مع Argon
أتاحت Google نموذج Gemini 4 Carbon في 10 نوفمبر 2026. تعرّف على أسعار واجهة البرمجة وشروط الوصول والفروق بينه وبين Argon ومتى تختار كل نموذج.
نموذج اللغة كحَكَم (LLM-as-a-judge): كيف يقيّم الذكاء الاصطناعي ومتى يخطئ؟
يستخدم LLM-as-a-judge نموذجًا لتقييم إجابات نموذج آخر. تعرّف على آلية عمله والتحيزات التي تكشفها الأبحاث وكيفية إعداد مقيّم موثوق.
Claude Fable 5.2 وClaude Mythos 5.2: الجديد والأسعار والاستخدامات
تعرّف على أسعار Claude Fable 5.2 وClaude Mythos 5.2 الرسمية، والوضع السريع، والفروق بينهما، ومتى تختارهما بدلًا من Claude Opus 5.5.
ما هو speculative decoding؟ كيف تقترح نماذج LLM الرموز وتتحقق منها بسرعة أكبر
يسرّع speculative decoding توليد نماذج LLM عبر اقتراح الرموز والتحقق منها بالتوازي. تعرّف على آلية عمله، ومتى يفيد، والعوامل التي تحدّ من سرعته.
ما هي KV cache؟ كيف تعيد نماذج LLM استخدام حالات الانتباه
تعرّف على KV cache ودورها في تسريع فك ترميز نماذج LLM، ونمو استهلاك الذاكرة مع طول السياق، وعلاقتها بتخزين المطالبات المؤقت وتكاليف API.
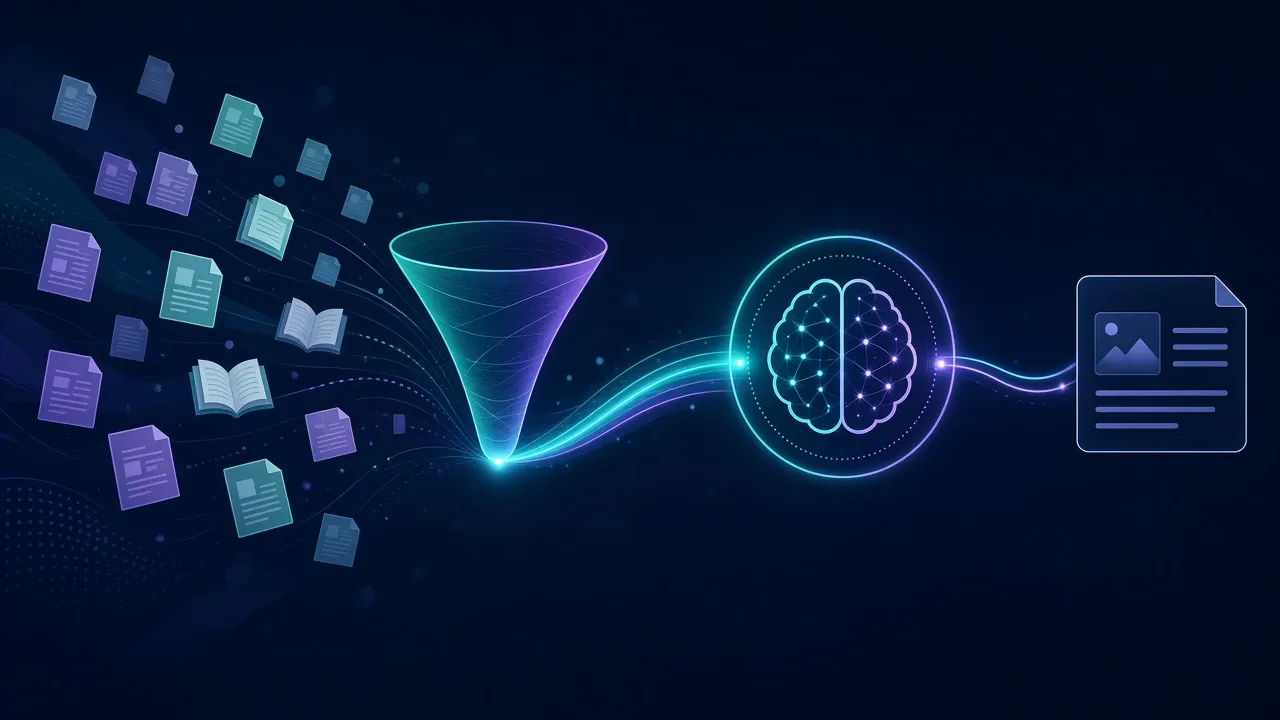
ما هو RAG؟ شرح التوليد المعزز بالاسترجاع
يسترجع RAG المستندات ذات الصلة قبل أن يجيب النموذج، مما يتيح له استخدام معلومات حديثة أو خاصة إلى جانب المعرفة التي اكتسبها أثناء التدريب.
سلاسل رسائل Claude API: ما الذي يتغير في جلسات الوكلاء الطويلة؟
تحتفظ Messages API من Anthropic بالمحادثة مؤقتًا على الخادم. تعرّف إلى أثر Message Threads في زمن الاستجابة وفاتورة الرموز وقواعد النسخة التجريبية.
Claude Opus 5.5 أم Sonnet 5.5؟ كيف تختار لعملك اليومي
قارن بين Claude Opus 5.5 وSonnet 5.5 من حيث الجودة والسرعة والسعر، واكتشف متى يكفي نموذج Anthropic الأقل تكلفة في مهام العمل اليومية.
ما الرمز (التوكن) في الذكاء الاصطناعي، ولماذا يحدد ما تدفعه؟
التوكن وحدة يعالج بها نموذج الذكاء الاصطناعي البيانات وتُحسب بها الرسوم. تعرّف على علاقته بالكلمات وأسعاره وكيف تقدّر تكلفة المهمة بالأمثلة.
معدلات هلوسة الذكاء الاصطناعي حسب النموذج: ماذا تقيس التصنيفات؟
أي نموذج ذكاء اصطناعي يهلوس أقل؟ نقارن أرقام GPT-6 وClaude وGemini 4 ونشرح معنى معدلات الهلوسة وسبب اختلاف نتائج التصنيفات بين الاختبارات.