Lotook

Mixture of Experts(MoE、専門家混合)は、層を複数の専門家サブネットワークに分割し、学習済みのrouterを使って各入力をその一部に振り分けるニューラルネットワークのアーキテクチャです。スパースなMoE言語モデルでは、各トークンが全パラメータの一部しか有効化しないため、モデルの容量とトークンごとの計算量を切り離せます。
Mixture of ExpertsのLLMはどう動く?
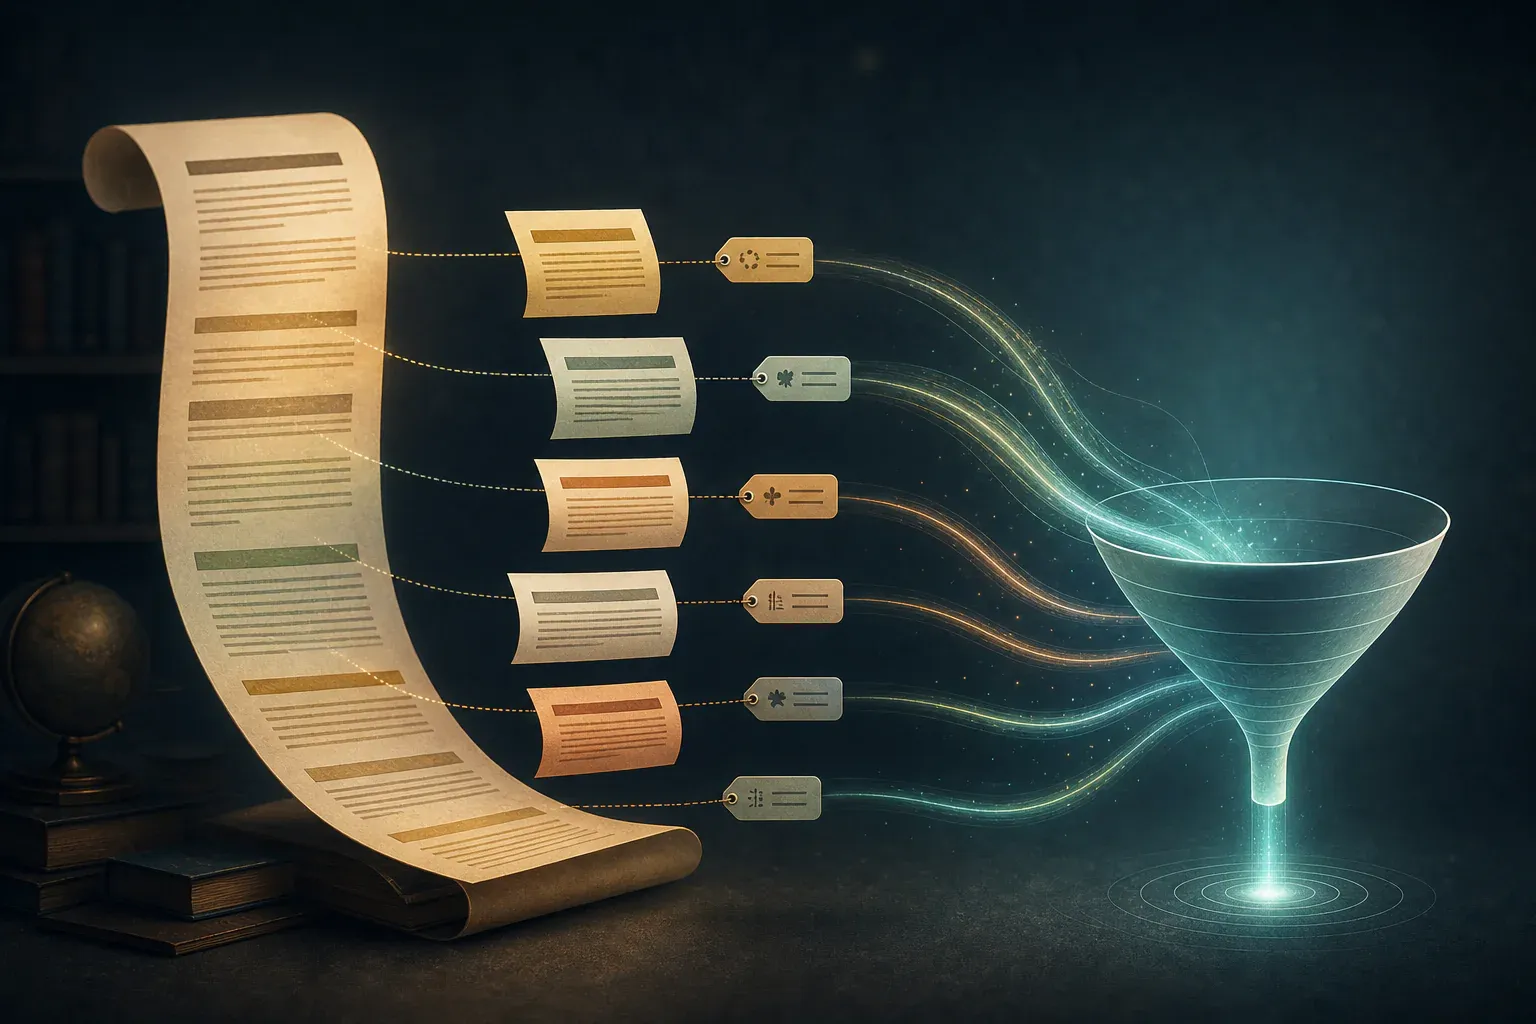
Mixture of ExpertsのLLMは、Transformerの各層にある標準的なフィードフォワードブロックを、トークンごとのrouterが制御する複数の並列な専門家ネットワークに置き換えます。標準的なTransformerモデルでは、アテンション層と密なフィードフォワードネットワーク(FFN)層が交互に並びます。MoE設計では、アテンションブロックはすべての入力で共有される一方、FFNブロックは独立した専門家サブネットワークの集合になり、それぞれが通常は個別のFFNとして構築されます。
routerと専門家による各トークンの処理
AIモデルのトークンはそれぞれTransformerの層を順に通過し、routerは各トークンを独立して評価します。ゲーティングネットワークとも呼ばれるrouterは、層内の学習済みコンポーネントです。典型的な実装では、routerは小さな線形層と、それに続いて入力トークンに対する各専門家のスコアを算出するsoftmax関数で構成され、top-k選択が組み合わされます。
routerがそのトークンに最適な k 個の専門家を選ぶと、選ばれた専門家だけがその出力を計算します。モデルは選ばれた専門家の出力を、通常は重み付けして加算することで結合し、隠れ状態を次のTransformerブロックに渡します。
スパースMoEと密なMoE
実務者は、各入力に対して実行される専門家の数に基づいて、密なMoEとスパースMoEを区別します。密なMoE層では、すべての専門家がすべての入力に対して実行されます。スパースなmixture of experts層では、あるトークンに対してrouterが選んだtop-kの専門家だけが実行されます。アーキテクチャの説明に密なルーティングと明記されていない限り、現代のLLMの文書ではMoEはスパースな方式の略称として使われます。
MoEモデルのアクティブパラメータと総パラメータ
MoEモデルのモデルカードを読むには、アクティブパラメータと総パラメータの違いを理解することが重要です。スパースMoEモデルは多くの専門家ネットワークを保存しながら、トークンごとに少数しか有効化しないため、一つのパラメータ数だけではメモリ上のサイズとトークンごとの計算量の両方を表せません。
総パラメータは、スパースパラメータとも呼ばれ、すべての専門家FFN、router、共有アテンションブロック、埋め込み層、出力層を含むモデル全体の重みを数えたものです。モデルの開発者が各層に専門家を追加すると、総パラメータ数は増えます。
アクティブパラメータは、1つのトークンに対する順伝播で実行される重みの一部だけを数えたものです。この数には、すべてのトークンで実行される共有層と、各MoE層で選ばれる k 個の専門家が含まれます。k を増やすとアクティブパラメータは直接増えますが、k を固定したまま専門家の総数を増やしても、routerのわずかな追加負荷を除けばほぼ変わりません。順伝播の計算量とトークンごとの遅延はアクティブパラメータに密接に連動する一方、モデルの読み込みに必要なメモリは総パラメータに連動します。
Mixture of Expertsと密なモデルの比較
Mixture of Expertsと密なモデルの比較では、パラメータ数がトークンごとの計算とシステムメモリにどう対応するかが要点です。密なTransformerでは、すべてのフィードフォワード層のすべての重みが、各トークンの処理に関与します。密なモデルの容量を拡大すると、トークンごとの計算量も同じペースで増えます。
スパースなMoEアーキテクチャは、この連動を断ち切ります。選択される数 k を一定に保ちながら専門家の総数 n を増やすことで、総パラメータ容量を拡大しつつ、トークンごとの計算量をおおむね k とrouterの実行にかかる小さなコストに応じた水準に保てます。
| 比較項目 | 密なモデル | スパースMoEモデル |
|---|---|---|
| 総パラメータ | 全層にわたる一体の重みの集合 | 共有層とすべての n 個の専門家サブネットワークの合計 |
| トークンごとのアクティブパラメータ | 総パラメータと同じ(100%がアクティブ) | 共有層と各層のtop-k 専門家からなる一部 |
| トークンごとの計算量 | 総パラメータ数に直接比例 | 主にアクティブパラメータに比例(routerの小さなコストを加算) |
| モデルの読み込みに必要なメモリ | 総パラメータに比例 | 総パラメータに比例(通常は全専門家がメモリに残る) |
この表はモデル評価の重要なルールを示しています。実行速度やトークンごとの計算効率を比較するとき、スパースMoEモデルとアクティブサイズが同程度の密なモデルを比べることが公平な基準になります。一方、総パラメータ数が同じ密なモデルとの比較では、異なる規模の処理を比べることになります。
Mixture of Expertsの起源は?
Mixture of Expertsの概念は、現代の大規模言語モデルより20年以上前に生まれました。研究者たちはTransformerアーキテクチャが存在するずっと前から条件付きルーティングを研究し、そのアイデアを徐々に大規模化してきました。
1991年、Robert Jacobs、Michael Jordan、Steven Nowlan、Geoffrey HintonはNeural ComputationにAdaptive Mixtures of Local Expertsを発表し、ゲーティングネットワークが異なる入力を別々のローカルな専門家ネットワークに振り分ける教師あり学習の枠組みを紹介しました。
2017年、Noam Shazeerと共著者は、ICLR 2017で発表されたOutrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layerで、スパースなゲーティングを大規模な言語モデリングに応用しました。この研究は、スパースにゲートされたMoE層を挿入することで、例ごとの計算量を比例して増やさずにニューラルネットワークのパラメータ数を大幅に拡大できると示しました。
2021年、William Fedus、Barret Zoph、Noam ShazeerはSwitch Transformersを発表しました。Switch routingはトークンを2つ以上の専門家に振り分ける代わりに、各トークンを k=1 個の専門家に送ります。著者らは、単一の専門家へのルーティングによって、k > 1 の場合と比べてモデルの品質を維持しながら、routerの計算量とデバイス間通信を減らせると主張しました。
具体例:Mixtral 8x7B
Mistral AIが公開したMixtral 8x7Bは、アーキテクチャの数値が十分に文書化されたMixtralのmixture of expertsモデルとして、提供元自身による明確な公開例です。2023年12月11日にMixtral of expertsのブログ記事で発表され、付随するMixtral of Expertsの論文で詳述されたMixtral 8x7Bは、Apache 2.0ライセンスで公開されたデコーダーのみのスパースなmixture-of-experts言語モデルで、コンテキスト長は32kトークンです。
Mixtral 8x7Bでは、各Transformer層のフィードフォワードブロックに8つの専門家パラメータグループがあります。学習済みrouterは、各層の各トークンについて8つの専門家から2つを選び(k=2)、その出力を加算して結合します。
Mistral AIのリリースノートによると、総パラメータは46.7B、トークンごとに使用されるパラメータは12.9Bです(技術論文ではそれぞれ総数47B、アクティブ13Bに丸めています)。この数値は、8に7Bを掛けた推定がなぜ誤解を招くかを示しています。アテンションブロックなどの共有コンポーネントは8回複製されないため、総パラメータは46.7Bである一方、トークンごとの実行で使われるのは12.9Bだけです。
Mixtral 8x7Bは、重みが公開された初期の十分に文書化されたMoEとして、基本的な仕組みを明確に示しています。その後の最先端モデルもMoE方式のスパースなフィードフォワード層を採用していますが、商用プロバイダーは専門家の正確な数やルーティング構成を公表しないことが多くあります。
MoEはコストとモデル選択に何を意味する?
Mixture of Expertsアーキテクチャは、AIモデルを選ぶ際のトークンごとの推論コストとハードウェアのメモリ容量のバランスを変えます。この2つの制約がどう分かれるかを理解すれば、モデルカードから本番環境でのホスティングやAPI評価に移る際の予想外の事態を避けられます。
トークンごとの計算量とメモリ使用量
順伝播の計算量は総パラメータではなくアクティブパラメータに連動するため、スパースMoEモデルは、より小さな密なモデルに近い計算量で各トークンを処理できます。トークンごとの計算量が少ないと、実行速度の向上や生成トークンあたりの計算コストの低下につながることが多く、大量の処理でAI APIのコストを削減する方法を検討する際に重要です。
メモリの計画は異なります。プロンプトやバッチ内の異なるトークンは、どの層のどの専門家にも振り分けられるため、MoEモデルの提供には通常、すべての専門家を同時に保持できるメモリとメモリ帯域幅が必要です。パラメータのオフロードを使わない限り、Mixtral 8x7Bをホスティングするには、各トークンが12.9Bを有効化するだけでも、46.7Bの全パラメータをメモリに収める必要があります。
公平な比較基準を選ぶ
私はデプロイメントプロジェクトのモデルカードを確認するとき、メモリの規模を決めるための総パラメータと、計算量を見積もるためのアクティブパラメータを並べて記録します。MoEモデルをアクティブサイズが同程度の密なモデルと比べると、トークンごとの計算量を現実的に把握できます。一方、総パラメータ数からは、どのクラスのハードウェアなら実際に重みを読み込めるかが分かります。
Mixture of Expertsではないもの
MoEモデルが何ではないかを明確にすることで、学習の手順、外部データの検索、個々の専門家が実際に学習する内容についてのよくある誤解を防げます。
アーキテクチャと学習・検索
Mixture of Expertsは、モデルの層に組み込まれたニューラルネットワークのアーキテクチャパターンです。既存の重みを調整したり、より小さな密なモデルに能力を移したりするファインチューニングや蒸留など、学習後の手法とはまったく異なる役割を果たします。
Mixture of Expertsは検索拡張生成(RAG)とも役割が異なります。RAGは実行時に外部の知識ベースを検索して関連するコンテキストをプロンプトに加えますが、MoEのrouterはモデルの固定された重みの中で、内部サブネットワーク間にトークンを振り分けるだけです。MoEモデルを使っても、アプリケーションが文書をリアルタイムに検索できるようにはなりません。
専門家は人間が扱うトピックに特化する?
専門家という言葉を聞くと、あるサブネットワークはPythonコード、別のサブネットワークはスペイン語の文法、さらに別のものは数学の証明を扱うと思いがちです。特定のチェックポイントでそのような動作を示した引用論文の実証分析がない限り、人間が解釈できるトピックへの特化を前提にすべきではありません。学習中、学習済みrouterは学習損失を最小化するために入力を数学的に分割するので、人間の科目名できれいに分類できる保証はありません。
FAQ
ここでは、スパースなmixture of experts言語モデルを評価する実務者からよく寄せられる実用的な質問に答えます。
MoEとは簡単に言うと何ですか?
MoE、つまりmixture of expertsは、1つの大きなフィードフォワード層を複数の小さな専門家サブネットワークと学習済みrouterに置き換えるニューラルネットワークの設計です。routerは入力トークンごとに少数の専門家だけを選んで実行し、トークンごとの計算量をモデル全体のパラメータ規模より低く抑えます。
密なモデルとMoEモデルの違いは何ですか?
密な言語モデルは、各トークンを処理するためにパラメータの100%を使用します。スパースMoE言語モデルは各層に複数の専門家ネットワークを保存し、各トークンをtop-kの専門家だけに振り分けます。その結果、密なモデルの計算量は総パラメータに直接連動し、スパースMoEモデルの計算量は主にアクティブパラメータに連動します。
MoEモデルの読み込みにはなぜ多くのメモリが必要なのですか?
各トークンが使うのはMoEモデルのパラメータの一部だけでも、実行時には異なるトークンがネットワーク内のどの専門家にも振り分けられます。提供用フレームワークがパラメータのオフロードを利用しない限り、すべての専門家にすぐアクセスできるよう、システムは全パラメータをメモリに保持する必要があります。
MoEのLLMはトークンごとに何人の専門家を有効化しますか?
トークンごとのアクティブな専門家数はkで表され、モデルの設計によって異なります。Switch Transformerはルーティングの追加負荷と通信を最小限にするため、各トークンをちょうど1つの専門家(k=1)に振り分けました。Mixtral 8x7Bのような公開モデルは、各層で8つの専門家から2つを選び(k=2)、その出力を加算します。
Mixture of ExpertsはRAGやファインチューニングに代わるものですか?
Mixture of Experts、RAG、ファインチューニングはそれぞれ異なる問題を解決するため、Mixture of ExpertsはRAGやファインチューニングに代わるものではありません。MoEは、モデルの重みの中で内部層が計算をどう振り分けるかを定義します。RAGは回答を最新のデータに基づかせるために外部文書を取得し、ファインチューニングは特定のタスクや回答形式に合わせてモデルの振る舞いを更新します。
出典
この解説のアーキテクチャの定義、歴史的な出来事、Mixtral 8x7Bの数値は、以下の一次研究論文と公式リリース文書に基づいています。
- Adaptive Mixtures of Local Experts(Jacobs、Jordan、Nowlan、Hinton、1991)
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer(Shazeerほか、2017)
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity(Fedus、Zoph、Shazeer、2021)
- Mixtral of experts(Mistral AIブログ、2023年12月11日)
- Mixtral of Experts(Mistral AI技術論文、arXiv:2401.04088)