 Lotook
저널 둘러보기
태그 AI 모델 글 — 2페이지
태그 AI 모델가 붙은 Lotook 글입니다. 뉴스, 분석, 실용 가이드와 원문 링크를 담습니다. 2 / 3 페이지.
Gemini 4 Carbon 정식 출시: 가격, 이용 방법과 Argon 비교
Google이 2026년 11월 10일 Gemini 4 Carbon의 정식 서비스를 시작했습니다. API 가격 변동과 이용 대상, Argon과의 차이 및 모델 선택 기준을 자세히 살펴봅니다. 주요 경쟁 모델의 가격과 기술 사양도 함께 확인하세요.
LLM-as-a-judge란? LLM 평가자의 작동 방식과 한계
LLM-as-a-judge는 한 모델로 다른 모델의 답변을 평가하는 방식입니다. 작동 원리와 연구에서 발견된 편향을 살펴보고, 신뢰할 수 있는 평가자를 설정하는 방법과 평가 편향을 완화하고 비용을 줄이는 방법까지 자세히 알아봅니다.
Claude Fable 5.2와 Claude Mythos 5.2: 새 기능과 가격, 활용법
Claude Fable 5.2와 Claude Mythos 5.2의 공식 API 가격, 빠른 모드, 두 모델의 차이와 Claude Opus 5.5 대신 선택할 때를 살펴봅니다. 접근 조건과 벤치마크, 보안 및 데이터 보존 유의사항도 정리했습니다.
speculative decoding이란? LLM이 토큰을 더 빠르게 예측하고 검증하는 방법
speculative decoding은 후보 토큰을 미리 생성하고 병렬로 검증해 LLM의 출력을 빠르게 만듭니다. 작동 단계와 속도 향상의 조건, KV cache와의 관계, 실제 연구 결과 및 API 개발자가 알아야 할 한계까지 살펴봅니다.
KV cache란? LLM이 어텐션 상태를 재사용하는 방법
KV cache가 무엇인지, LLM의 디코딩 속도를 높이는 원리와 컨텍스트 길이에 따른 메모리 증가를 알아봅니다. 프롬프트 캐싱 및 API 비용과의 관계, Prefill과 Decode의 차이, 개발자를 위한 실용적인 운영 방법도 살펴봅니다.
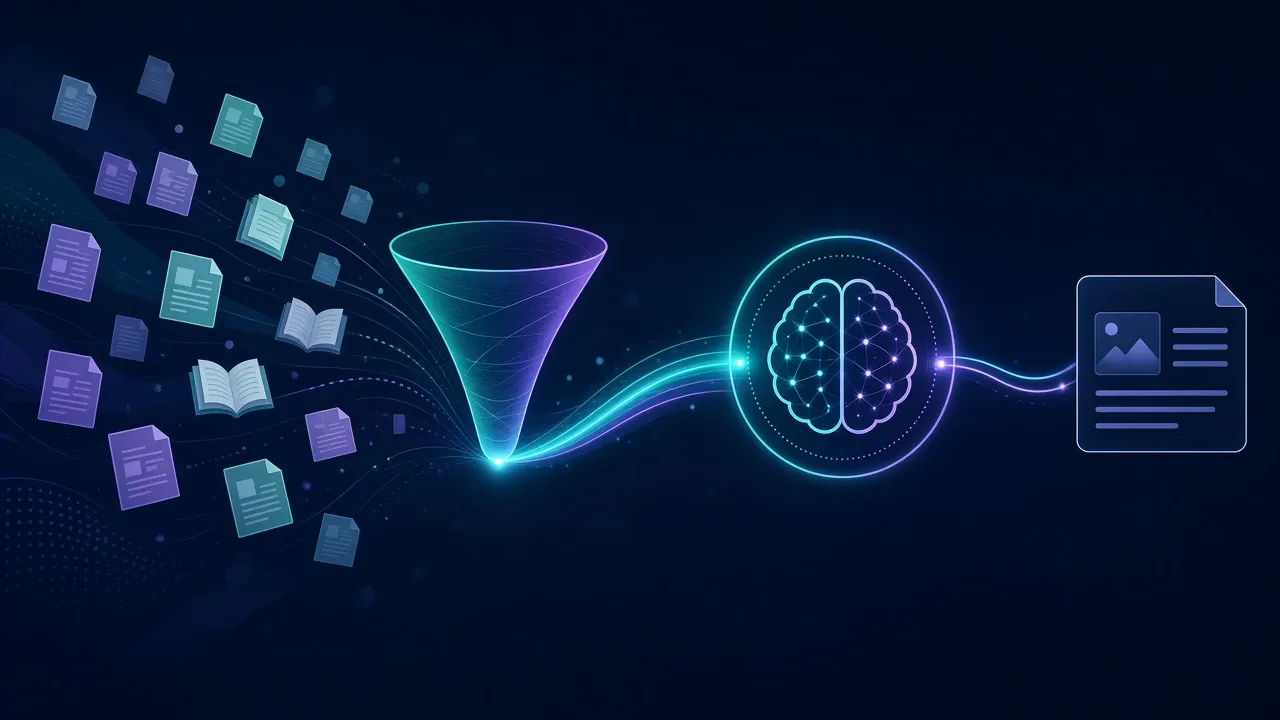
RAG란? 검색 증강 생성의 개념과 작동 방식
RAG는 답변을 생성하기 전에 관련 문서를 검색해 언어 모델에 전달하는 검색 증강 생성 방식입니다. 학습 데이터에만 의존하지 않고 최신 정보나 비공개 데이터를 활용할 수 있습니다. RAG의 단계별 작동 방식과 한계, 안정적인 시스템을 구축할 때 살펴볼 사항을 알아봅니다.
Claude API Message Threads: 긴 에이전트 세션에서 달라지는 점
Anthropic의 Messages API는 대화를 서버에 잠시 보관합니다. Message Threads가 지연 시간을 줄이는 방식과 변하지 않는 토큰 과금, 베타 이용 규칙을 살펴봅니다. 긴 에이전트 세션에서 스레드를 만들고 이어가는 방법과 만료 시 복구 절차도 설명합니다.
Claude Opus 5.5와 Sonnet 5.5 중 무엇을 고를까? 일상 업무를 위한 선택법
Claude Opus 5.5와 Sonnet 5.5의 품질, 속도, 가격 차이를 비교합니다. 일상 업무에서 저렴한 Sonnet으로 충분한 경우와 Opus를 선택할 상황, 노력 설정에 따른 실제 비용 변화까지 자세히 살펴봅니다.
AI 토큰이란 무엇이며 비용을 결정하는 이유는?
AI 토큰은 모델이 텍스트와 이미지를 처리하고 사용량을 청구하는 기본 단위입니다. 토큰과 단어의 차이, 입력과 출력 및 추론 토큰의 가격, 언어별 토큰 수와 실제 작업 비용을 추정하는 방법을 구체적인 예시와 함께 알아봅니다. 컨텍스트 한도와 비용 절감 방법도 살펴봅니다.
모델별 AI 환각률: 할루시네이션 순위는 무엇을 측정하나
GPT-6, Claude, Gemini 4 중 어떤 AI 모델의 할루시네이션이 가장 적을까요? 최신 환각률을 비교하고 평가 순위가 서로 다른 이유와 각 숫자가 실제로 의미하는 바와 일상 업무에서 수치를 활용하는 방법까지 자세히 살펴봅니다.