 Lotook
ジャーナルを見る
タグ「AIモデル」の記事 — 2ページ
Lotookでタグ「AIモデル」が付いた記事です。ニュース、考察、実践ガイドと原典へのリンクを含みます。 2 / 3 ページ。
Gemini 4 Carbonが一般提供開始:料金、利用方法、Argonとの比較
Googleは2026年11月10日にGemini 4 Carbonの一般提供を開始しました。APIの料金改定、利用できる人、Argonとの違いと使い分けを解説します。割引期間や主要モデルとの料金比較、利用条件、技術仕様、安全性の評価結果も詳しく紹介します。
LLM-as-a-judgeとは?LLMによる評価の仕組みと落とし穴
LLM-as-a-judgeは、あるモデルの回答を別のモデルで評価する手法です。その仕組みや研究で判明したバイアス、信頼できる評価者を構築するための方法を、具体的な手順とともにわかりやすく解説します。人間による評価との比較や、位置バイアスへの対策、評価コストを抑える方法も紹介します。
Claude Fable 5.2とClaude Mythos 5.2の新機能・料金・使い分け
AnthropicのClaude Fable 5.2とClaude Mythos 5.2について、公式料金、高速モード、両モデルの違い、Opus 5.5との使い分けを解説します。アクセス条件やベンチマーク、安全性とデータ保持に関する注意点も紹介します。
speculative decodingとは?LLMがトークンを高速に予測・検証する仕組み
speculative decodingは、候補トークンを先に生成し、大きなモデルで並列に検証することでLLMの出力を高速化します。その具体的な仕組みや速度向上の条件、KV cacheとの関係、API開発者への影響、実際の研究結果と利用上の限界をわかりやすく解説します。
KVキャッシュとは?LLMがAttentionの状態を再利用する仕組み
KVキャッシュとは何か、LLMのDecodeを高速化する仕組み、コンテキスト長に伴うメモリの増加、プロンプトキャッシュやAPIコストとの関係をわかりやすく解説します。PrefillとDecodeの違いや、開発チームが実践できる運用上のポイントも紹介します。
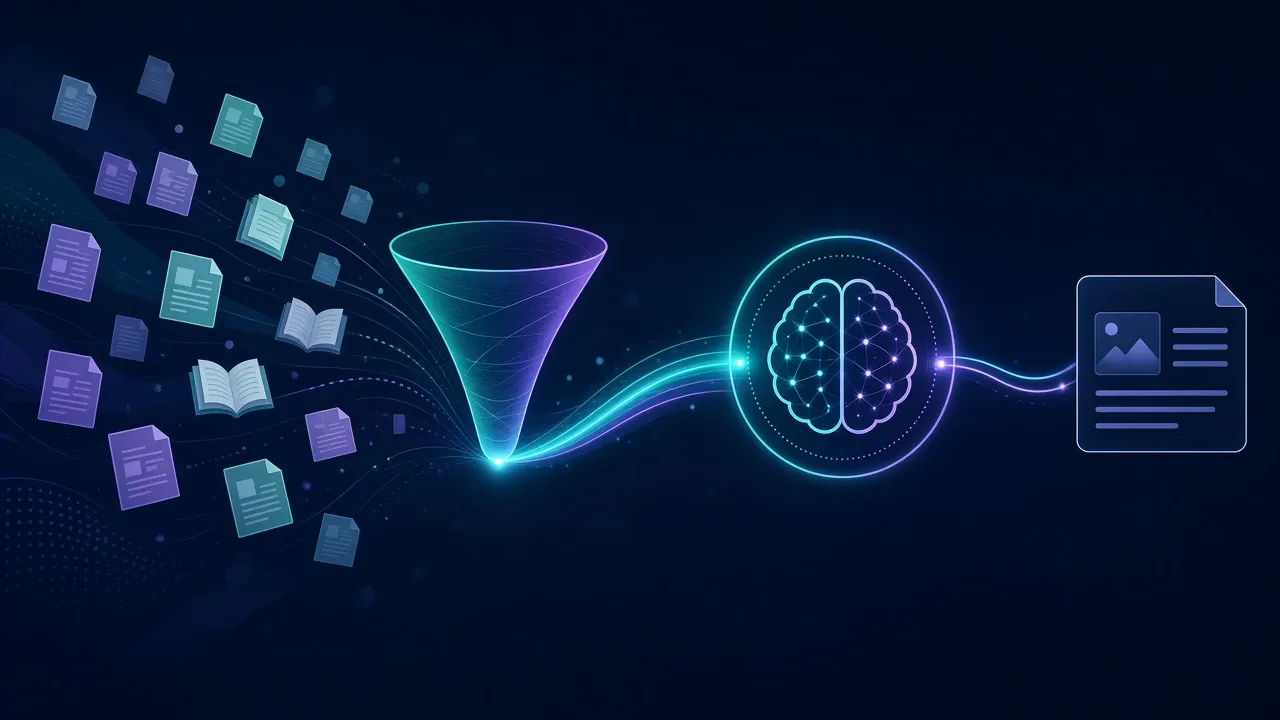
RAGとは?検索拡張生成の仕組みを解説
RAG(検索拡張生成)は、回答を生成する前に関連文書を検索し、その内容を言語モデルに渡す手法です。学習時の知識だけに頼らず、社内の非公開情報や更新された最新情報を使って回答できます。仕組みや従来の手法との違い、導入時の注意点を詳しく解説します。
Claude API Message Threads:長時間のエージェントセッションで何が変わるか
AnthropicのMessages APIは会話をサーバーに短時間保持できます。Message Threadsによる遅延の改善、変わらないトークン課金、ベータ版の仕組みと利用上のルールを詳しく解説します。長いエージェント実行での使い方や有効期間、制約、復旧方法も確認できます。
Claude Opus 5.5とSonnet 5.5、日々の仕事にはどちらを選ぶ?
Claude Opus 5.5とSonnet 5.5の品質、速度、価格を比較。Anthropicの2つのモデルの違いと、日々のオフィス業務で安価なSonnetが十分な場面、より複雑な判断にOpusを選ぶべき場面、思考設定によるコストの違いを詳しく解説します。
AIのトークンとは? 料金を左右する理由
AIのトークンとは、モデルが文章や画像などを読み書きし、利用料金を計算する基本単位です。単語との違いや言語による数の変化、入力・出力・推論の料金、タスクごとの費用の見積もり方を、具体例とともに解説します。コンテキストの上限についても確認しましょう。
モデル別AIの幻覚率:ハルシネーションのランキングは何を測るのか
GPT-6、Claude、Gemini 4のハルシネーション率を比較。どのモデルが最も幻覚を起こしにくいのか、文書要約と知識テストの違い、ランキングごとに結果が異なる理由、数字を読む際の注意点と日々の仕事で役立つ確認方法をわかりやすく解説します。